
· 22 min read

この文章が役に立つと思われる方は、ぜひ Github リポジトリに ⭐ をつけてください!

また、この文章は私のブログにも掲載されています。

frontend-test.001.jpeg

テストファイル命名規則​

テストファイルの命名は通常

  1. *.spec.ts(おすすめ)
  2. *.unit.ts
  3. *.test.ts

とされています。

*.test.ts は比較的古い命名方法です。

最もよく使われるのは *.spec.ts で、おすすめです。

命名規則に従うことが重要です。

なぜなら、多くのライブラリやツールは **/*.spec.ts のパターンでテストファイルを識別するためです。

テストを書くメリット​

  1. コードのリファクタリング

    コードは家のようなもので、定期的にメンテナンスしないとすぐに老朽化(ろうきゅうか)します。

    プロジェクトにおいて、常にコードをリファクタリングすることは非常に重要です。

    しかし、リファクタリングは新しいバグを生み出すリスクがあり、多くの人がそれをためらいます。

    テストがあれば、リファクタリングを安心して行うことができます。

    古い機能に新しいバグが導入された場合、すぐに知ることができます。

  2. 単体テストはプログラム設計を逆向きに改善します

    プログラム設計が悪い場合、単体テストも書きにくくなります。

    単体テストを書くためには、プログラム設計も良好である必要があります。

    プログラム設計には以下のような要素が必要です:

    1. 単一責任原則
    2. 高い凝集性(ぎょうしゅうせい)
    3. 低い結合度

    これらが欠けていると、単体テストを書くことは難しくなります。

  3. 単体テストは「生きたドキュメント」

    単体テストは、実行可能なドキュメントです。

    新しいメンバーを迎え入れる際に、単体テストがあれば、彼らに一から教える必要はありません。

  4. 他人のコードのチェック

    同僚が新機能を追加するかバグを修正するブランチを提出した場合、そのコードが既存の機能に影響を与えていないかどうかをどのように確認しますか?

    以前のすべての機能を一つ一つ確認することは不可能です。

    なので、以前のすべての機能に対してテストを実行する必要があります。

  5. 長期的に見ると開発時間の節約につながります

    終わりのない重複する手動テストを自動化します。

  6. バグの早期発見

  7. ... ...

単位レベルの機能テスト​

単体テストは単位レベルの機能テストです。

伝統的な単体テストの問題点​

伝統的な単体テストでは、関数を単位としてテストします。

  1. 私的なメソッドとエクスポートされていない関数

    エクスポートされていない場合、テストが困難になります。

    エクスポートすると、モジュールのカプセル化に影響します。

    結果として、これらの私的なメソッドはテストされなくなることが多いです。

  2. 関数ごとにテストを行う場合、後にロジックの構造を調整する必要が生じた場合、テストの構造も変更する必要があります。

    これにより、機能のメンテナンスに加えて、テストのメンテナンスも必要になります。

機能を単位として​

frontend-test.012.jpeg

単位レベルの機能テスト は Test Driven Development: By Example に由来します。

正しいアプローチは、機能を単位として単体テストを行うことです。

各関数に対して単体テストを書くのではなく、一つの機能を単位としてテストを書きます。

システムは様々な機能で構成されており、機能を単位としてテストすることで、具体的な機能実装のロジック構造を調整しても、テストを変更する必要がなくなります。

これにより、私的なメソッドに対するテストも不要になります。

機能を単位とした単体テストはより堅牢(けんろう)です。

一つの機能は複数の関数で構成されることも、一つの関数で構成されることもあります。

単体テストの書き方​

単体テストの書き方には 3 つのアプローチがあります​

  1. 機能を書く ==> 手動で確認/デバッグ ==> テストを書き、自動化で確認/デバッグ
  2. 機能を書く ==> テストを書き、自動化で確認/デバッグ ⭐
  3. テストを書き、自動化で確認/デバッグ ==> 機能を書く ⭐⭐⭐

最初の方法は最も苦痛(くつう)であり、テストに対する嫌悪感(けんおかん)を引き起こす可能性があります。

2 番目の方法では、手動での確認/デバッグを自動化された確認/デバッグで置き換えます。

3 番目の方法は TDD であり、最も推奨される方法です。

TDD の 3 ステップ​

frontend-test.013.jpeg

  1. テストを書く(まだ通過できない)

    これにより、要件を明確に理解することができます。

    テストを書くことで、プログラムの外部インターフェースを設計していることにもなります。

  2. テストを通過させるためのビジネスコードを書く

    テストのエラーに基づいて、一歩ずつコードを書きます。

  3. リファクタリング

Bug を修正する時にも、必ずその Bug を再現できるテスト、または Demo を作成した次第、修正してきましょう。

単体テストの作成流れ​

frontend-test.019.jpeg

Steps
1. テスト用データを準備givenArrange(準備)
2. テスト対象の機能/関数を呼び出すwhenAct(実行)
3. 機能の出力を検証thenAssert(検証)
4. ティアダウン

Arrange-Act-Assert (AAA) パターンに従う:準備(Arrange)、実行(Act)、アサート(Assert)。

第一歩と第四歩は必ずしも必要ではありませんが、第二歩と第三歩は必要です。

例えば、getName() をテストする時に、データの準備は必要ありません。

また、グローバルなデータに関わらない場合は、ティアダウンの必要がありません。

テスト中に、グローバルなデータやキャッシュを扱うことがあり、これらは元に戻す必要があります。これはティアダウンの役割です。

Vitest は何​

frontend-test.020.jpeg

Vitest は、特にパフォーマンスの最適化や最新の JavaScript 機能への対応において、Jest に比べて、より現代的なテストフレームワークです。

なぜ Vitest を選択​

  1. 高速な実行

    Vite の高速なホットリロード技術を利用し、テストの起動と実行が非常に速いです。

  2. Vite ベースの設計

    Vite 上に構築されており、Vite の強力なビルドと最適化機能を活用しています。

    この二つの特徴により、特に大規模なプロジェクトにおいて、テストの実行速度が大幅に向上します。

    開発者にとって使いやすく、効率的なテスト体験を提供することで、プロジェクトの品質向上に貢献しています。

  3. 現代的な JavaScript エコシステムとの互換性

    ES モジュールのサポートなど、最新の JavaScript 機能と完全に互換性があります。

  4. 設定不要のゼロコンフィグレーション

    ほぼ追加設定なしで、使用できます。

    特に、Vitest は Vite の設定を共有できます。

    Jest は設定やサードパーティのライブラリ(@types/jest, ts-jest など)のインストールが必要です。

  5. Jest からの移行容易(ようい)性

    Jest の API 名と比較して、グローバル API や vi の API レベル以外に大きな変更がないため、Vitest への移行は容易です。

  6. コミュニティの活動度

    技術選定の際には、コミュニティの活動度も重要な指標です。

    Vitest - Github

    Jest - Github

    コミットの密度(① みつど)を見ることで、コミュニティの活動度を判断できます。

Vitest のコア API​

Vitest の API は Jest や MochaJS に似ています。

test と it​

test のタイプ: (name: string, fn: TestFunction, timeout?: number | TestOptions) => void

必要に応じて、タイムアウト(ミリ秒単位)を指定して、終了までの待機時間を設定できます。

デフォルトは 5 秒で、testTimeout で全体的に設定可能です。

test は it のエイリアスです。

import { test, it } from "vitest";

test("should do something", () => {});

it("should do something", () => {});

ソフトウェアエンジニアリングでは、BDD(行動駆動開発) は、開発者、品質保証専門家、およびソフトウェアプロジェクトの顧客代表間のコラボレーションを奨励するアジャイルなソフトウェア開発プロセスです。

これは TDD から派生しました。

プロジェクトで test か it を自由に使うことができますが、両方を同時に使用しないでください。

describe テストスイート​

describe を使用すると、現在のコンテキストで新しいスイートを定義できます。

これは関連するテストやベンチマーク、その他のネストされたスイートのセットです。

スイートを使用すると、テストやベンチマークを整理して、レポートをより明確にすることができます。

import { describe, expect, it } from "vitest";

describe("remove", () => {
const user = {
name: "nansen",
};

it("should remove an item", () => {
expect(user.name).toBe("nansen");
});

it("should remove two items", () => {
expect(user.name).toBe("nansen");
});
});

テストやベンチマークに階層(かいそう)がある場合、describe ブロックをネストすることもできます。

import { describe, test, it } from "vitest";

describe("", () => {
it("", () => {});
it("", () => {});
});

describe("", () => {
it("", () => {});
it("", () => {});
});
});

expect​

expect はアサーションを作成するために使用されます。

toBe と toEqual​

toBe は プリミティブが等しい か、または オブジェクトが同じ参照を共有している ことをアサートするために使用できます。

JavaScript では、プリミティブ(原始値、原始データ型)はオブジェクトではなく、メソッドやプロパティを持たないデータです。

7 つのプリミティブデータ型があります:null、undefined、boolean、number、string、symbol、BigInt。

オブジェクト が同じでない場合 でも、構造が同一であるかどうか を確認したい場合は toEqual を使用できます。

toEqual は 実際の値が受け取った値と等しい か、または オブジェクトであれば同じ構造を持つ(再帰的に比較する) ことをアサートします。

Error オブジェクトに対しては深い等価性は行われません。

何かがスローされたかどうかをテストするには、toThrowError アサーションを使用してください。

  • toBe はプリミティブや同じ参照を共有するオブジェクトに使用されます。
  • toEqual は同じ参照を共有しない値/オブジェクト(Error オブジェクトを除く)に使用されます。
import { it, expect } from "vitest";

it("toBe", () => {
// `toBe` は === と同じです
expect(1).toBe(1);
});
import { it, expect } from "vitest";

const user = {
name: "nansen",
};

it("toEqual", () => {
expect(user).toEqual({
name: "nansen",
});
});

toBeTruthy と toBeFalsy​

toBeTruthy は値が Boolean に変換されたときに真であることをアサートします。

toBeFalsy は値が Boolean に変換されたときに偽であることをアサートします。

JavaScript では、truthy 値は Boolean コンテキストで遭遇したときに true とみなされる値です。

すべての値は truthy であり、false、0、-0、0n、""、null、undefined、NaN を除きます。

import { expect, test } from "vitest";

test("toBeTruthy", () => {
expect(1).toBeTruthy();
});

toContain​

toContain は、実際の値が配列内にあるかどうかをアサートします。

また、ある文字列が別の文字列の一部文字列であるかどうかもチェックできます。

import { expect, it } from "vitest";

const item1 = { name: "nansen" };
const item2 = { name: "erica" };
const list = [item1, item2];

it("toContain", () => {
expect(list).toContain(item1);
});

toThrow および toThrowError​

タイプ:(received: any) => Awaitable<void>

toThrowError は toThrow のエイリアスです。

toThrowError は、関数が呼び出された際にエラーを投げるかどうかをアサートします。

特定のエラーが投げられるかをテストするために、オプショナルな引数を提供することができます:

正規表現:エラーメッセージがパターンに一致する。 文字列:エラーメッセージにその部分文字列が含まれている。

import { expect, it } from "vitest";

it("toThrow", () => {
function sayHi(name) {
if (typeof name !== "string") {
throw new Error("wrong name");
}
return `Hi, ${name}!`;
}

expect(() => sayHi(111)).toThrow("wrong");
});

テストのセットアップと終了の API​

beforeEach と beforeAll​

タイプ: beforeEach/beforeAll(fn: () => Awaitable<void>, timeout?: number)

beforeEach は、現在のコンテキストで実行される各テストの前に一度呼び出されるコールバックを登録します。

test() が呼び出される回数と同じ回数、beforeEach() が呼び出されます。

beforeAll は、現在のコンテキストでのすべてのテストの実行を開始する前に一度呼び出されるコールバックを登録します。

関数がプロミスを返す場合、Vitest はテストを実行する前にプロミスが解決するまで待ちます。

オプションで、終了するまでの待ち時間を定義するタイムアウト(ミリ秒単位)を渡すことができます。

デフォルトは 5 秒です。

import { beforeEach } from "vitest";

beforeEach(async () => {
// モックのクリア
await stopMocking();
// 各テスト実行前にいくつかのテストデータを追加
await addUser({ name: "John" });
});

beforeEach は、各テストごとにユーザーが追加されることを保証します。

import { beforeAll } from "vitest";

beforeAll(async () => {
// すべてのテストが実行される前に一度呼び出されます。
await startMocking();
});

beforeEach と beforeAll はオプションのクリーンアップ関数(afterEach / afterAll に相当)を受け入れます。

import { beforeEach, beforeAll } from "vitest";

beforeEach(async () => {
// 各テストが実行される前に一度呼び出されます。
await prepareSomething();

// クリーンアップ関数、
// 各テスト実行後に一度呼び出されます。
return async () => {
await resetSomething();
};
});

beforeAll(async () => {
// すべてのテストが実行される前に一度呼び出されます。
await startMocking();

// クリーンアップ関数、
// すべてのテスト実行後に一度呼び出されます。
return async () => {
await stopMocking();
};
});

afterEach と afterAll​

タイプ: afterEach/afterAll(fn: () => Awaitable<void>, timeout?: number)

afterEach は、現在のコンテキストのテストのうちの 1 つが完了した後に呼び出されるコールバックを登録します。

afterAll は、現在のコンテキストのすべてのテストが実行された後に一度呼び出されるコールバックを登録します。

関数がプロミスを返す場合、Vitest はプロミスが解決するまで続行する前に待ちます。

オプションで、終了するまでの待ち時間を定義するタイムアウト(ミリ秒単位)を渡すことができます。

デフォルトは 5 秒です。

import { afterEach } from "vitest";

afterEach(async () => {
// 各テストが完了した後にテストデータをクリアします。
await clearTestingData();
});
import { afterAll } from "vitest";

afterAll(async () => {
// このメソッドはすべてのテストが実行された後に呼び出されます。
await clearTestingData();
});

関数がプロミスを返す場合、Vitest はプロミスが解決するまで続行する前に待ちます。

セットアップとティアダウン API の呼び出し順序​

import {
beforeAll,
beforeEach,
afterAll,
afterEach,
describe,
it,
} from "vitest";

// 1
beforeAll(() => {
console.log("beforeAll");
});

// 2 5
beforeEach(() => {
console.log("beforeEach");
});

// 3
it("", () => {
console.log("it");
});

describe("nested", () => {
// 6
beforeEach(() => {
console.log("nested beforeEach");
});
// 7
it("nested it", () => {
console.log("nested it");
});
// 8
afterEach(() => {
console.log("nested afterEach");
});
});

// 4 9
afterEach(() => {
console.log("afterEach");
});

// 10
afterAll(() => {
console.log("afterAll");
});

それぞれを使用するタイミング​

  • beforeAll(一度だけ呼び出される)

    1. データベースに接続する場合。
    2. 一時ファイルを作成する場合。
  • afterAll(一度だけ呼び出される)

    1. データベースから切断する場合。
    2. 一時ファイルを削除する場合。
  • beforeEach(test() が呼び出される回数、その回数だけ beforeEach が呼び出される)

    1. ストアに新しいデータを作成する場合。
    2. ストアの状態を設定する場合。
  • afterEach(test() が呼び出される回数、その回数だけ afterEach が呼び出される)

    1. ストア内の一時的なデータを削除する場合。
    2. ストアの状態をリセットする場合。

フィルター​

only​

  1. test.only()
  2. bench.only()
  3. describe.only()

skip​

  1. test.skip()
  2. bench.skip()
  3. describe.skip()

todo​

  1. test.todo()
  2. bench.todo()
  3. describe.todo()

Vitest CLI​

実行するテストファイルのフィルターとして追加の引数を渡すことができます。例えば

# api.spec.ts のみをテストする場合

vitest api

vitest watch/dev はすべてのテストスイートを実行しますが、変更があった場合に監視して変更があった際に再実行します。

vitest run は、監視モードなしで一度だけ実行します。

ソースコードで Vitest の API をより深く理解​

一般的な API をより深く理解するために、自分でテストフレームワークを実装します。

実装したリポジトリ:mini-test-runner。
· 14 min read

git merge の紹介​

マージの基本的な構文は:git merge <branch> です。

マージ操作は、複数のブランチの開発履歴を一つに統合し、全てのブランチのコミットを保持します。そして、マージ操作の完了を示す新しいマージコミット(merge commit)が追加されます。

ここで、以下のような fix と master ブランチ、およびコミット履歴があるとします:

        A --- B --- C  fix
/
D --- E --- F --- G master

この時点で、fix ブランチの最新のコードを master ブランチにマージしたいと考えています。

master ブランチで git merge fix コマンドを実行することができます。

これにより、fix ブランチのコミット内容(現在のブランチから分岐して以来の全てのコミット)が master ブランチにマージされます。

その結果、コミット履歴は次のようになります:

        A --- B --- C  fix
/ \
D --- E --- F --- G --- H master

master ブランチのコミット履歴には、新しいマージコミット H が追加されます。

H のコミットには、fix ブランチの全ての A、B、C のコミットが含まれます。

git merge を避けるべき場面​

git merge を使うと、ブランチのすべてのコミット履歴が保存され、さらに新しいマージコミットが追加されます。これは公共のブランチでは良いマージ戦略です。

しかし、プライベートブランチや共有されていないブランチでこれを行うと、問題が生じやすいです。

次のような feature と master ブランチ、およびコミット履歴があるとします:

D --- E --- F --- G  master
\
A --- B feature

feature ブランチを開発している間に、master ブランチが二度更新されました。

feature ブランチのコードを develop ブランチにマージしてテストする前に、コードの整合性を保つために master ブランチの最新のコードを feature ブランチにマージする必要があります。

この時点で git merge を続けると、コミット履歴は次のようになります:

D --- E --- F --- G  master
\ \
A --- B --- H feature

つまり、feature ブランチのコミット履歴は次のようになります:

A --- B --- H(F と G が含まれている)  feature

H のコミットには master ブランチの最新のコミット、すなわち F と G が含まれます。

コードのマージが成功した後、feature ブランチのコードを git merge を使って公共のブランチ develop にマージします。

コミット履歴は次のようになります:

D --- E --- F --- G  master
\ \
A --- B --- H feature
\
X --- Y --- Z ----------- M develop

develop ブランチには M コミットが追加され、M コミットには feature ブランチのすべてのコミット(A、B、H)が含まれ、H コミットには master ブランチの F と G が含まれます。

この例では、コミット数がわずか数回でも、2 回のマージ後に feature ブランチと develop ブランチの Git コミット履歴がこれほど複雑になります。

コミット数が増え、マージ回数が増えると、コードレビューやデバッグやコードの履歴追跡が非常に困難になります。

私が経験した中で、コミット数が 200 を超える場合の MR がありましたが、これはメインブランチの最新コードをマージした結果です。

したがって、余分なコミット履歴を削除し、コミット履歴をクリーンに保つことが重要です。

これにより、コードのレビューが楽になり、コードのデバッグやコードの履歴追跡も理解しやすくなります。

git rebase の紹介​

リベースの基本的な構文は: git rebase <branch> です。

コードの統合を行う際、不要なコミット履歴を取り除き、履歴をシンプルで直線的に保つには、git rebase を使用する必要があります。

git merge とは異なり、git rebase はマージコミットを作成せず、現在のブランチのコミットを基準ブランチの最新コミットに再適用します。これにより、現在のブランチの履歴が基準ブランチの最新コミットから直接派生したかのように見え、履歴が直線的でシンプルになります。

上記の git merge が適さない場面の問題解決​

上記と同じ、以下のような feature と master ブランチ、およびコミット履歴があるとします:

D --- E --- F --- G  master
\
A --- B feature

feature ブランチを開発している間に、master ブランチが二度更新されました。

feature ブランチのコードを develop ブランチにマージしてテストする前に、コードの一貫性を保つために master ブランチの最新コードを feature ブランチにマージする必要があります。

この時点で git merge ではなく git rebase を使用すると、コミット履歴は次のようになります:

D --- E --- F --- G  master
\
A --- B feature

つまり、feature ブランチのコミット履歴は次のようになります:

A --- B  feature

不要な H、F、G のコミットが含まれていません。

リベースが成功した後、feature ブランチのコードを git merge を使用して公共のブランチ develop にマージします。

コミット履歴は次のようになります:

D --- E --- F --- G  master
\
A --- B feature
\
X --- Y --- Z --------------- M develop

develop ブランチには M コミットが追加され、M コミットには feature ブランチの全てのコミット(A と B)が含まれます。

以前の git merge を使用した場合と比較して、develop ブランチに追加された M コミットには feature ブランチの全てのコミット(A、B、H)が含まれ、H には master ブランチの F と G のコミットが含まれています。

現在、M コミットには feature ブランチのコミット(A と B)のみが含まれています。

上記の例から、プライベートブランチや共有されていないブランチで git rebase を使用して基準ブランチの最新コードを取り込むことで、次のような利点があります:

  1. コミット履歴を直線的で分かりやすく保つ

    これにより、プロジェクトのコミット履歴が読みやすく理解しやすくなり、コードレビューが容易になります。

    また、デバッグやコードの遡りにおいても、コードの進化過程が理解しやすくなります。

  2. 不要なマージコミットを避ける

  3. 早期にコンフリクトを解決し、協力効率を向上させる

    git rebase によって早期にコンフリクトを解決することで、最終的なマージ時の複雑さを軽減できます。

    さらに、基準ブランチの最新の変更を定期的にプライベートブランチに適用することで、常に最新のコードベースに基づいて作業を行い、チームメンバー間のコードコンフリクトを減らすことができます。

コンフリクトがない場合​

git rebase <branch> を実行した後、コードにコンフリクトがなければ、そのままリベースが完了しています。

その後は git push -f を使ってリモートブランチにコードをプッシュするだけです。

なぜ git push -f を使う必要があるのでしょうか?

git rebase を実行すると、Git は各コミットに新しいコミットオブジェクトを作成します。これらの新しいコミットオブジェクトは、内容が同じであっても元のコミットとは異なります。

そのため、ローカルブランチのコミット履歴がリモートブランチの履歴と一致しなくなります。

これらの変更をリモートリポジトリにプッシュしようとすると、Git はローカルのコミット履歴がリモートの履歴とコンフリクトしていると判断します。なぜなら、それらは異なるコミットハッシュを持っているからです。

これらの変更を強制的にプッシュするには、git push -f を使用する必要があります。これにより、リモートブランチの履歴が上書きされ、ローカルブランチと一致するようになります。

git push -f を使用する必要があるため、プライベートブランチや共有されていないブランチのみでリベース操作を行うことが重要です。

コードのコンフリクトの処理​

git rebase <branch> を実行した際にコードにコンフリクトが発生した場合、Git は次のようなメッセージを表示します:

(base) nansenho@mb-nansyou-01 dragonfly_frontend % git rebase develop
Auto-merging tests/e2e/specs/error/404.spec.ts
CONFLICT (add/add): Merge conflict in tests/e2e/specs/error/404.spec.ts
error: could not apply 03652542... fix:404エラーページのe2eテスト
hint: Resolve all conflicts manually, mark them as resolved with
hint: "git add/rm <conflicted_files>", then run "git rebase --continue".
hint: You can instead skip this commit: run "git rebase --skip".
hint: To abort and get back to the state before "git rebase", run "git rebase --abort".
Could not apply 03652542... fix:404エラーページのe2eテスト

このメッセージは、コンフリクトを解決するための三つの方法を教えてくれます:

  • git rebase --continue

    git rebase の途中でコンフリクトが発生し、手動で全てのコンフリクトを解決した後、git add <file> を使って解決済みのファイルをマークします。

    その後、git rebase --continue を実行してリベース操作を続行します。

    リベース操作が完了したら、git push -f を使用してローカルの変更をリモートブランチにプッシュします。

  • git rebase --abort

    リベース中に問題が発生し、現在のリベース操作を中止することを決定した場合、git rebase --abort を使用できます。

    このコマンドは現在のリベース操作をキャンセルし、リベースを開始する前の状態にブランチを戻します。

  • git rebase --skip

    現在のコードコンフリクトを無視することを決定した場合、git rebase --skip を使用できます。

    このコマンドは現在のコンフリクトを引き起こしているコミットをスキップします。

実際にコンフリクトが発生した場合、最も推奨される方法は、手動でコンフリクトを解決した後に git rebase --continue を使用してリベースを続行することです。

解決できないコンフリクトが発生した場合や、現在のリベース操作が実行不可能であると判明した場合は、git rebase --abort を使用してリベース操作をキャンセルし、元の状態に戻してから他の解決策を考えることをお勧めします。

git rebase --skip を使用するのは推奨されません。

git rebase と git merge の使用シーン​

一般的に、すべてのブランチの完全なコミット履歴を保持したい場合はマージを使用し、コミット履歴をシンプルかつ直線的に保ちたい場合はリベースを使用します。

具体的には、以下の二つの広く認識されている使用シーンがあります:

  • プライベートブランチや共有されていないブランチ(例:feature-xxx、fix-xxx、refactor-xxx など)で開発を行う際、他のブランチの最新コードを取り込む場合、コミット履歴をシンプルかつ直線的に保つために git rebase を使用するのが適しています。

  • プライベートブランチや共有されていないブランチ(例:feature-xxx、fix-xxx、refactor-xxx など)を共有ブランチ(例:master、develop、main など)にマージする際には、すべてのコミット履歴を記録するために git merge を使用し、コード変更の追跡を容易にするのが適しています。

参考​

· 8 min read

.gitlab-ci.yml​

stages:
- test
- build

default:
image: node:lts
cache:
key:
files:
- package.json
paths:
- node_modules/
- package-lock.json

before_script:
- npm ci

unit_test_job:
stage: test
variables:
TZ: "Asia/Tokyo"
script:
- npm run test-ut
tags:
- dragonfly
- frontend

component_test_job:
image: mcr.microsoft.com/playwright:v1.43.0-jammy
stage: test
variables:
TZ: "Asia/Tokyo"
before_script:
- apt-get update && apt-get install -y python3 python3-pip
- npm ci
script:
- npm run test-ct
tags:
- dragonfly
- frontend

build_job:
stage: build
script:
- npm run build
tags:
- dragonfly
- frontend

この .gitlab-ci.yml のコードは、GitLab CI/CD のパイプラインを設定しています。

まず、2 つのステージ、test と build を定義しています。

デフォルト設定では、node:lts イメージを使用し、package.json と node_modules/、package-lock.json をキャッシュしています。

before_script では、node_modules ディレクトリが存在しない場合に npm ci を実行します。

unit_test_job では、test ステージで npm run test-ut を実行します。 component_test_job では、test ステージで npm run test-ct を実行します。 build_job では build ステージで npm run build を実行します。

component_test_job では、playwright が提供してくれる mcr.microsoft.com/playwright:v1.43.0-jammy image を使っています。

GitLab Runner にも apt-get update && apt-get install -y python3 python3-pip で  Python をインストールしています。

各ジョブには dragonfly と frontend のタグが付いています。

これにより、コードの更新があるたびに自動的にテストとビルドが行われます。

CI/CD Runner​

プロジェクト専用の GitLab CI/CD Runner は以下のように設定されています。

# 同時に実行できるジョブの数を 1 に設定しています。
concurrent = 1
# Runner がジョブをチェックする間隔は特に設定されていません。
check_interval = 0
# Runner のシャットダウンタイムアウトは設定されていません。
shutdown_timeout = 0

[session_server]
session_timeout = 1800 # セッションサーバーのタイムアウト時間を 1800 秒(30分)に設定しています。

[[runners]]
name = "DragonFly-FE" # Runner の名前を「DragonFly-FE」に設定されています。
url = "https://gitlab.firstloop-tech.com" # GitLab の URLが指定されています。
# すべての CI/CD タスク(ビルドやテストなど)はこの GitLab インスタンスがあるサーバー環境で実行されます。
id = 12 # Runner の ID が指定されています。
token = "glrt-mk-3FfFyysbC7Pz3TUJs" # Runner の Token が指定されています。
token_obtained_at = 2024-01-18T07:12:02Z
token_expires_at = 0001-01-01T00:00:00Z
executor = "docker" # Docker を実行環境として使用します。
[runners.cache]
MaxUploadedArchiveSize = 0 # キャッシュされたアーカイブの最大アップロードサイズに制限は設けられていません。
[runners.docker]
tls_verify = false # TLSの検証を行わない設定です。
image = "node:lts" # 使用するDockerイメージとして「node:lts」が指定されています。
pull_policy = ["if-not-present", "always"] # イメージのプルポリシーとして「存在しない場合と常にプルする」が設定されています。
privileged = false # 特権モードは使用しない設定です。
disable_entrypoint_overwrite = false # エントリポイントの上書きを禁止していません。
oom_kill_disable = false # OutOfMemory Killerの無効化は行っていません。
disable_cache = false # キャッシュの無効化は行っていません。
volumes = ["/cache"] # キャッシュ用のボリュームとして「/cache」が設定されています。
shm_size = 0 # 共有メモリサイズMTUの設定は特に行っていません。
network_mtu = 0 # 共有ネットワークMTUの設定は特に行っていません。

パイプラインスケジュール​

GitLab のスケジュール機能は、定期的に CI/CD パイプラインを実行することができ、特定の時間や間隔でタスクを実行する必要がある場合、例えば夜間のビルド、定期的なデータバックアップ、定期的なテストに特に便利です。

現在の E2E テストは不安定で時間がかかるため、コード変更に基づくパイプラインではなく、定期的に実行するタスクに追加することを決めました。

これを行うには、まずパイプラインスケジュールを設定し、その後 .gitlab_ci.yml ファイルを設定する必要があります。

パイプラインスケジュールの設定​

スケジュールの設定​

  • GitLab プロジェクトにアクセスする

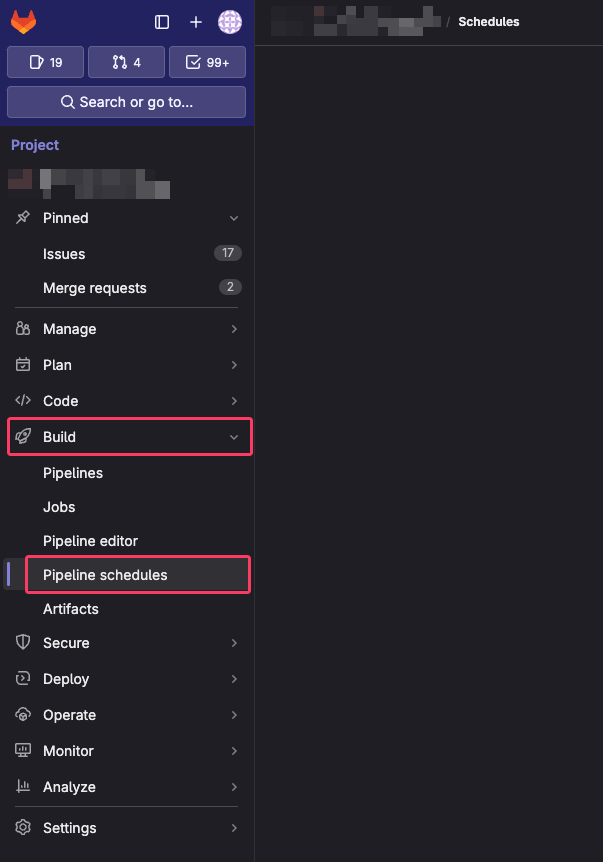
  • プロジェクトのサイドバーから Build の下にある Pipeline schedules を選択し、クリックして進む

    Pipeline schedules

  • Pipeline Schedules 設定ページに移動したら、New Schedule ボタンをクリックして新しいスケジュールを作成する

  • スケジュールの名前を設定する

  • Cron 式を入力する

    # ┌───────────── 分(0〜59)
    # │ ┌───────────── 時(0〜23)
    # │ │ ┌───────────── 日(1〜31)
    # │ │ │ ┌───────────── 月(1〜12)
    # │ │ │ │ ┌───────────── 曜日(0〜6〈日〜土〉、一部のシステムでは7も日曜日)
    # │ │ │ │ │
    # │ │ │ │ │
    # * * * * * [予約するコマンド]
  • 対象ブランチを指定する

  • 設定を保存する

.gitlab-ci.yml の更新​

GitLab CI では、スケジュールはパイプラインを最小単位として実行されます。

しかし、すべてのジョブが実行されるわけではなく、特定のジョブだけを実行したい場合は、rules フィールドを使用してジョブの実行タイミングを詳細に設定することができます。

example_job:
rules:
- if: $CI_PIPELINE_SOURCE != "schedule"

$CI_PIPELINE_SOURCE == "schedule" を使用すると、このジョブがスケジュールによってトリガーされたパイプラインでのみ実行されるように設定できます。

rules フィールドには複数の if 条件を設定でき、1 つの if 条件が満たされればジョブが実行されます。

複数の条件をすべて満たす場合にのみジョブをトリガーするには、&& を使用して複数の条件を関連付ける必要があります。

example_job:
rules:
- if: $CI_PIPELINE_SOURCE != "schedule" && $CI_COMMIT_BRANCH == "master"

注意:only と except フィールドも rules フィールドと同様にジョブの実行タイミングを設定できるため、1 つのジョブでこれらの設定を同時に使用することはできません。

更新された完全な .gitlab-ci.yml ファイル​

.install_dependencies: &install_dependencies
before_script:
- apt-get update && apt-get install -y python3 python3-pip zip
- npm ci

.default_tags: &default_tags
tags:
- dragonfly
- frontend

variables:
SERVER_URL: http://localhost:3000
PLAYWRIGHT_DOCKER_IMAGE: mcr.microsoft.com/playwright:v1.45.0-jammy
TOKYO_TZ: Asia/Tokyo

stages:
- test
- build

default:
image: node:lts
cache:
key:
files:
- package.json
paths:
- node_modules/
- package-lock.json

unit_test_job:
stage: test
variables:
TZ: $TOKYO_TZ
script:
- npm ci
- npm run test-ut
<<: *default_tags
rules:
- if: $CI_PIPELINE_SOURCE != "schedule"

e2e_test_job:
image: $PLAYWRIGHT_DOCKER_IMAGE
stage: test
<<: [*install_dependencies, *default_tags]
script:
- npm run dev &
- npx wait-on $SERVER_URL --timeout 30000
- npm run e2e-test
timeout: 30m
rules:
- if: $CI_PIPELINE_SOURCE == "schedule"

build_dev_job:
stage: build
<<: [*install_dependencies, *default_tags]
artifacts:
name: out_dev
paths:
- out_dev.zip
expire_in: 1 week
script:
- npm run build:dev
- zip -r out_dev.zip ./out
rules:
- if: $CI_PIPELINE_SOURCE != "schedule" && $CI_COMMIT_BRANCH == "develop"

build_prod_job:
stage: build
<<: [*install_dependencies, *default_tags]
artifacts:
name: out_prod
paths:
- out_prod.zip
expire_in: 1 week
script:
- npm run build:prod
- zip -r out_prod.zip ./out
rules:
- if: $CI_PIPELINE_SOURCE != "schedule" && $CI_COMMIT_BRANCH == "master"

build_other_job:
stage: build
<<: [*install_dependencies, *default_tags]
script:
- npm run build:dev
rules:
- if: $CI_PIPELINE_SOURCE != "schedule" && $CI_COMMIT_BRANCH != "master" && $CI_COMMIT_BRANCH != "develop"

· 4 min read

インストール Vitest​

以下のコマンドで、Vitest をインストールします。

pnpm i vitest -D
# あるいは
yarn add vitest -D
# あるいは
npm i vitest -D

Vitest が Develop 環境に使われるので、-D を必ずつけてインストールしてください。

pnpm でインストールするのがおすすめです。

vitest.config.ts 設定​

もしプロジェクト内に vitest.config.ts と vite.config.ts が共存する場合、vitest.config.ts の設定が vite.config.ts の設定よりも優先され、上書きされます。

以下の vitest.config.ts ファイルを行ごとにコメントで解説します。

// `vitest/config` の `defineConfig` を使用します。
import { defineConfig } from "vitest/config";
import path from "path";

// glob パターンを利用して、テスト不要のファイルを定義します。
const defaultExclude: string[] = [
// node_modules に含まれる .ts と .js 拡張子のファイル
"node_modules/**/*.{ts,js}",
// パッケージング後の成果物に含まれる .ts と .js 拡張子のファイル
"out/**/*.{ts,js}",
// E2Eテストとコンポーネントテストのディレクトリに含まれる .ts と .js 拡張子のファイル
"tests/**/*.{ts,js}",
// 設定ファイル
"**/*.config.{ts,js}",
// story に関するファイル
"**/*.stories.{ts,js}",
".storybook/*.{ts,js}",
// .next に含まれる .ts と .js 拡張子の
".next/**/*.{ts,js}",
// 型定義ファイル
"**/types/*.{ts,js}",
"**/type/*.{ts,js}",
"**/*.d.ts",
// ダミーデータを定義しているファイル
"**/*dummy*.{ts,js}",
"**/*sample*.{ts,js}",
// スタイルファイル
"**/*Style*.{ts,js}",
];
// glob パターンマッチングでカバーされていない、テスト不要のファイルは指定されたパスで除外します。
const specificFilesExclude: string[] = [
// 特定のファイルのパス
"auth/aw-exports.ts",
"components/input/IconInputValidation.ts",
// ...
];
// テスト不要の全てのファイルを定義します。
const excludedFiles = [...defaultExclude, ...specificFilesExclude];

export default defineConfig({
// `vitest` を設定するには、設定ファイルに `test` 属性を追加する必要があります。
test: {
// Vitest のデフォルトのテスト環境は Node.js 環境です。
// Webアプリケーションを構築している場合は、Node.js を jsdom や happy-dom などのブラウザライクな環境に置き換えることができます。
environment: "happy-dom",
// テストファイルを含む glob パターンを定義します。
include: ["**/*.spec.{js,ts}"],
// テストファイルを除外する glob パターンを定義します。
// tests フォルダには E2E テストとコンポーネントテストが含まれているため、除外されます。
exclude: excludedFiles,
// テストカバレッジデータを収集するには、coverage 属性を追加する必要があります。
coverage: {
// provider でテストカバレッジデータを収集するツールを選択します。
provider: "v8",
// テストカバレッジデータの収集を有効にします。
enabled: true,
// テストが失敗しても、カバレッジレポートは生成されます。
reportOnFailure: true,
// テストカバレッジレポーターの形式を設定します。
reporter: ["text", "json", "html"],
// テストカバレッジに含まれるテスト対象の glob パターンを定義します。
include: ["**/*.{ts,js}"],
// テストカバレッジから除外されるテスト対象の glob パターンを定義します。
exclude: excludedFiles,
},
},
resolve: {
alias: {
"@": path.resolve(__dirname, "./"),
},
},
});

ディレクトリ構造​

テストファイルはテスト対象モジュールと並列に __tests__ ディレクトリに配置します。

store
├── __tests__
│ ├── utils
│ │ └── index.spec.ts
│ └── count.spec.ts
├── count.ts
└── utils
└── index.ts

store ディレクトリにさらに深いディレクトリ構造が存在する場合は、__tests__ ディレクトリも同じ構造を維持するべきです。

テストファイルの命名​

各テストファイルは一つのモジュールまたはコンポーネントのみをテストします。

テストファイルの命名は *.spec.ts をします。

例えば、component.js のテストファイルは component.spec.js とします。

· 4 min read

単体テストの最小単位​

単体テストでは、関数ではなく、機能を最小単位としてテストすべきです。

関数を単位としてテストする問題点​

伝統的な単体テストでは、関数を単位としてテストします。

  1. 私的なメソッドとエクスポートされていない関数

    エクスポートされていない場合、テストが困難になります。

    エクスポートすると、モジュールのカプセル化に影響します。

    結果として、これらの私的なメソッドはテストされなくなることが多いです。

  2. 関数ごとにテストを行う場合、後にロジックの構造を調整する必要が生じた場合、テストの構造も変更する必要があります。

    これにより、機能のメンテナンスに加えて、テストのメンテナンスも必要になります。

機能を単位として​

単位レベルの機能テスト は Test Driven Development: By Example に由来します。

正しいアプローチは、機能を単位として単体テストを行うことです。

各関数に対して単体テストを書くのではなく、一つの機能を単位としてテストを書きます。

システムは様々な機能で構成されており、機能を単位としてテストすることで、具体的な機能実装のロジック構造を調整しても、テストを変更する必要がなくなります。

これにより、私的なメソッドに対するテストも不要になります。

機能を単位とした単体テストはより丈夫です。

単体テストを作成する四つのステップ​

Steps
1. テスト用データを準備givenArrange(準備)
2. テスト対象の機能/関数を呼び出すwhenAct(実行)
3. 機能の出力を検証thenAssert(検証)
4. ティアダウン

Arrange-Act-Assert (AAA) パターンに従う:準備(Arrange)、実行(Act)、アサート(Assert)。

第一歩と第四歩は必ずしも必要ではありませんが、第二歩と第三歩は必要です。

例えば、sayHi をテストする時に、データの準備は必要ありません。

function sayHi() {
console.log("Hi!");
}

テスト中にはグローバルなデータやキャッシュを扱うことがありますが、これらは後で元に戻す必要があります。 これがティアダウンの役割です。

しかし、そのようなデータに関わらない場合は、ティアダウンは必要ありません。

最初の単体テストを作成する​

以下の単体テストを行ごとにコメントで解説します。

import { test, expect } from "vitest";
import { useTodoStore, reset } from "../todo.ts";

// テストケースは説明的な英語で記述し、テストの目的を明確になるようにします。
test("add todo", () => {
// 1. テスト用データを準備
const todoStore = useTodoStore();
const title = "eat";

// 2. テスト対象の機能/関数を呼び出す
useTodoStore.addTodo(title);

// 3. 機能の出力を検証
expect(todoStore.todos[0].title).toBe(title);

// 4. ティアダウン
reset();
});

· 13 min read

Vitest とは​

Vitest は、特にパフォーマンスの最適化や最新の JavaScript 機能への対応において、Jest に比べて、よりモダンなテストフレームワークです。

なぜ Vitest を選択​

  1. Vite ベースの設計

    Vite 上に構築されており、Vite の強力なビルドと最適化機能を活用しています。

    Vite の高速なホットリロード技術を利用し、テストの起動と実行が非常に速いです。

    この特徴により、特に大規模なプロジェクトにおいて、テストの実行速度が大幅に向上します。

    開発者にとって使いやすく、効率的なテスト体験を提供することで、プロジェクトの品質向上に貢献しています。

  2. ES6 との互換性

    ES モジュールを含む、最新の JavaScript 機能を完全にサポートしています。

  3. 設定不要のゼロコンフィグレーション

    Vitest は追加設定なしで、そのまま使用できます。

    Jest は設定やサードパーティのライブラリ(@types/jest, ts-jest など)の追加が必要です。

    また、Vitest は Vite の設定を利用できるので、Vite を使ったプロジェクトにはとても便利です。

  4. Jest から Vitest への移行の容易性

    Jest の API 名と比較して、グローバル API や vi の API レベル以外に、大きな変更がないため、Vitest への移行は容易です。

  5. コミュニティの活動度

    Vitest のコミュニティ活動は Jest に比べて活発です。

Vitest コマンド​

現在のディレクトリで vitest コマンドを起動します。

開発環境では自動的にウォッチ(watch)モードに入り、CI 環境では自動的に実行(run)モードになります。

vitest を実行する際に、パラメーターを追加することでテストファイルのフィルタリングができます。

# api.spec.ts のみをテストします
vitest api

Vitest の基本的な API の紹介​

test と it​

test は it のエイリアスです。

import { test, it } from "vitest";

describe("", () => {
it("should do something", () => {});
});

test("should do something", () => {});

各テストケースでは一つの概念のみをテストして、なるべく assertion の数を少なくするようにしてください。

単体テストの安定性と保守性を確保するために、テストケース間では相互に呼び出しを行うべきではなく、実行の順序に依存してもいけません。

悪い例:testCase2 が testCase1 の実行結果に依存し、その結果を testCase2 の入力として使用する場合。

テストの構造を整理し、より読みやすくするために、

  • describe を使用してテストをグループ化する場合は it でテストケースを記述し、
  • describe を使用しない場合は test を用いてテストケースを作成します。

describe テストスイート​

describe を使用すると、現在のコンテキストで新しいスイートを定義できます。

これは関連するテストやベンチマーク、その他のネストされたスイートのセットです。

describe スイートをよく使用して、テストやベンチマークを整理して、レポートをより明確にすることがとても大事です。

describe ブロックをネストすることもできます。

describe("useUsers", () => {
beforeEach(() => {
console.log("beforeEach");
});

describe("successful cases", () => {
beforeEach(() => {
console.log("beforeEach");
});

it("handles successful use user when the users have email", async () => {});

it("handles successful use user when the users haven't email", async () => {});
});

describe("failed cases", () => {
beforeEach(() => {
console.log("beforeEach");
});

it("handles use user failures", async () => {});

it("handles use user failures where the listUsersInGroup function returns without a Users attribute.", async () => {});

it("handles use user failures when the allGroups is [] and the fltGroup is ''", async () => {});
});
});

expect​

expect はアサーションを作成するために使用されます。

toBe と toEqual​

  • toBe はプリミティブや同じ参照を共有するオブジェクトに使用されます。

    toBe はプリミティブが等しいか、または オブジェクトが同じ参照を共有している ことをアサートするために使用できます。

    JavaScript では、プリミティブ(原始値、原始データ型)はオブジェクトではなく、メソッドやプロパティを持たないデータです。

    7 つのプリミティブデータ型があります:null、undefined、boolean、number、string、symbol、BigInt。

    toBe は === と同じです。

  • toEqual は同じ参照を共有しない値/オブジェクト(Error オブジェクトを除く)に使用されます。

    オブジェクトが同じではなくても、構造が同一であるかどうかを確認したい場合は toEqual を使用できます。

    toEqual は 実際の値が受け取った値と等しいか、または**オブジェクトであれば同じ構造を持つ(再帰的に比較する)**ことをアサートします。

    Error オブジェクトに対しては深い等価性は行われません。

    何かがスローされたかどうかをテストするには、toThrowError アサーションを使用してください。

import { test, expect } from "vitest";

test("toBe", () => {
expect(1).toBe(1);
});

test("toEqual", () => {
const user = {
name: "nansen",
};
expect(user).toEqual({
name: "nansen",
});
});

toBeTruthy と toBeFalsy​

toBeTruthy は値が Boolean に変換されたときに真であることをアサートします。

toBeFalsy は値が Boolean に変換されたときに偽であることをアサートします。

JavaScript では、false、0、-0、0n、""(空文字列)、null、undefined、NaN を除くすべての値が truthy と評価されます。

import { expect, test } from "vitest";

test("toBeTruthy", () => {
expect(1).toBeTruthy();
});

toContain​

toContain は、実際の値が配列内にあるかどうかをアサートします。

また、ある文字列が別の文字列の一部文字列であるかどうかもチェックできます。

import { expect, it } from "vitest";

const item1 = { name: "nansen" };
const item2 = { name: "erica" };
const list = [item1, item2];

it("toContain", () => {
expect(list).toContain(item1);
});

toThrowError と toThrow​

toThrow は toThrowError のエイリアスです。

toThrowError は、関数が呼び出された際にエラーを投げるかどうかをアサートします。

特定のエラーが投げられるかをテストするために、オプショナルな引数を提供することができます:

  • 正規表現:エラーメッセージがパターンに一致する。
  • 文字列:エラーメッセージにその部分文字列が含まれている。
import { expect, test } from "vitest";

function sayHi(name) {
if (typeof name !== "string") {
throw new Error("wrong name");
}
return `Hi, ${name}!`;
}

test("toThrow", () => {
expect(() => sayHi(111)).toThrow("wrong");
});

beforeEach と beforeAll と afterEach と afterAll​

  • beforeEach は、現在のコンテキストで実行される各テストの前に一度呼び出されるコールバックを登録します。

    test() が呼び出される回数と同じ回数、beforeEach() が呼び出されます。

  • beforeAll は、現在のテストスイートのすべてのテストケースが実行される前に一度だけ呼び出されるコールバック関数を設定するためのものです。

    関数がプロミスを返す場合、Vitest はそのプロミスが解決されるまで、テストの実行を待機します。

  • afterEach は、各テストが完了した後に実行されるコールバックを登録します。

  • afterAll は、現在のコンテキストでのすべてのテストが完了した後に一度だけ呼び出されるコールバックを登録します。

    関数がプロミスを返す場合、Vitest はプロミスが解決するまで待ちます。

import {
describe,
it,
beforeEach,
afterEach,
beforeAll,
afterAll,
} from "vitest";

describe("", () => {
beforeEach(async () => {
// 各テスト実行前にいくつかのテストデータを追加
await addUser({ name: "John" });
});

afterEach(async () => {
// 各テストが完了した後にテストデータをクリアします。
await clearTestingData();
});

beforeAll(async () => {
// すべてのテストが実行される前に一度呼び出されます。
await mockSomething();
});

afterAll(() => {
// このメソッドはすべてのテストが実行された後に呼び出されます。
resetGlobalData();
});

it("", () => {});
it("", () => {});
it("", () => {});
});

以下のように、beforeEach と beforeAll はクリーンアップ関数をオプションとして受け入れることができます。これは afterEach や afterAll と同じです。

import { beforeEach, beforeAll } from "vitest";

beforeEach(async () => {
// 各テストが実行される前に一度呼び出されます。
await prepareSomething();

// クリーンアップ関数、
// 各テスト実行後に一度呼び出されます。
return async () => {
await resetSomething();
};
});

beforeAll(async () => {
// すべてのテストが実行される前に一度呼び出されます。
await startMocking();

// クリーンアップ関数、
// すべてのテスト実行後に一度呼び出されます。
return async () => {
await stopMocking();
};
});

以下のコードでは、各部分の実行順序を考えてください。解答は記事の最後にあります。

import {
beforeAll,
beforeEach,
afterAll,
afterEach,
describe,
it,
} from "vitest";

beforeAll(() => {
console.log("beforeAll");
});

beforeEach(() => {
console.log("beforeEach");
});

it("", () => {
console.log("it");
});

describe("nested", () => {
beforeEach(() => {
console.log("nested beforeEach");
});
it("nested it", () => {
console.log("nested it");
});
afterEach(() => {
console.log("nested afterEach");
});
});

afterEach(() => {
console.log("afterEach");
});

afterAll(() => {
console.log("afterAll");
});

only、skip、todo フィルター​

only、skip、todo を使用して、実行するテストファイルをフィルタリングできます。

  • only は指定された部分のコードのみを実行するように設定します。

    test.only("", () => {});
    bench.only("", () => {});
    describe.only("", () => {});
  • skip は指定された部分のコードを実行しないように設定します。

    test.skip("", () => {});
    bench.skip("", () => {});
    describe.skip("", () => {});
  • todo は指定された部分のコードを後で実装するように保留します。

    テストレポートにはエントリが表示され、実行する必要があるテストの数を知ることができます。

    test.todo("", () => {});
    bench.todo("", () => {});
    describe.todo("", () => {});

解答​

import {
beforeAll,
beforeEach,
afterAll,
afterEach,
describe,
it,
} from "vitest";

// 1
beforeAll(() => {
console.log("beforeAll");
});

// 2 5
beforeEach(() => {
console.log("beforeEach");
});

// 3
it("", () => {
console.log("it");
});

describe("nested", () => {
// 6
beforeEach(() => {
console.log("nested beforeEach");
});
// 7
it("nested it", () => {
console.log("nested it");
});
// 8
afterEach(() => {
console.log("nested afterEach");
});
});

// 4 9
afterEach(() => {
console.log("afterEach");
});

// 10
afterAll(() => {
console.log("afterAll");
});

· 10 min read

外部サービスや状態などに依存する場合は、実際の実装にテストダブル代わってを使用してからテストを行う必要があります。

単体テストは、外部環境の影響を受けずに繰り返し実行可能であることを確保する必要があります。

テストダブルのタイプ​

テストダブルには以下の 5 種類があります:

  • ダミーオブジェクト (Dummy Object)

    ダミーオブジェクトは、実際にはプレースホルダーです。

    コード例:

    // sendEmail.ts
    function sendEmail(message: Message, recipient: Recipient) {
    console.log(message.subject);
    console.log(message.body);
    }
    // sendEmail.spec.ts
    test("dummy", () => {
    const message: Message = {
    subject: "heihei",
    body: "hahaha",
    };
    const dummyRecipient = {} as Recipient;

    sendEmail(message, dummyRecipient);
    });

    注意

    ダミーオブジェクトの命名は、可能な限り「dummy」で始まるようにすることで、コードの可読性が向上します。

  • スタブ (Stub)

    Stub は主に間接的な入力時に使用され、外部依存関係を代替し、テスト環境を制御し、テスト対象を管理します。

    このテスト対象のうち、私たちが関心を持っているのはその一部分だけであり、オブジェクト全体をテストする必要はありません。

  • スパイ (Spy)

    Spy は主に特定のオブジェクトへの呼び出しを監視および記録するために使用されます。

    これはそのオブジェクトの振る舞いに影響を与えません。

    Vitest で提供されている Spy の実装 API は vi.spyOn(object, method, accessType) です。

  • モック (Mock)

    モックはスタブとスパイの組み合わせです。

    Mock と Stub の違い

    単体テストにおいて

    1. スタブは間接的な入力を制御する方法であり、間接的な入力の実際の実装を置き換えます。スタブは値を返すだけでよいです。
    // スタブ
    vi.mock("packageName", () => {
    return {
    functionName: () => 2,
    };
    });
    1. モックはスタブに比べて、交流情報の記録と検証の機能が追加されています。
    // モック
    vi.mock("packageName", () => {
    return {
    functionName: vi.fn(() => 2),
    };
    });

    テストフレームワークの API では、実際にモック、スタブ、スパイの境界は非常に曖昧です。

    しかし、使用する際には、どのテストダブルタイプを使っているかを明確に理解しておく必要があります。

  • フェイク (Fake)

    Fake は複雑な実際のオブジェクトの振る舞いを模倣するために使用され、テスト対象の簡略化された完全な実装です。

    Stub & Mock と Fake の違い:

    • Stub と Mock は通常、完全な実装を提供することなく、テスト中の特定の状態や行動の検証に使用されます。
    • Fake は実際に機能する簡略化された実装を提供しますが、特定のインタラクションの詳細には焦点を当てません。

Vitest において、プログラムの間接入力を処理する​

直接入力と間接入力との違い​

  • 直接にパラメータを通じてデータを受け取り、計算を行う方法を直接入力と言います。

  • 間接入力とは、他のモジュール、関数、グローバルオブジェクトなど引数以外の方法でデータが入力されることを指します。

    これにより、プログラムの動作が外部の状態に依存し、その部分の予測不可能性が高まるため、特にテストの際にはこれらの影響を管理する必要があります。

「可预测」とは、特定の内容を入力したときに、毎回予測可能な特定の出力が得られることを指します。

もしテスト対象システム (SUT) 自体が安定しておらず、予測不可能な場合、例えばバックエンド API、第三者サービス、データベースなどがそうである場合、それらを予測可能なものにするためにテストダブルを使用する必要があります。

他のモジュールとライブラリーがエクスポートした関数を処理する​

vi.mocked で処理する場合のコード例:

import { userAge } from "./user";

// vi.mock() にモジュールのパスを入れる
vi.mock("./user");

describe("", () => {
it("* 2", () => {
// vi.mocked() にモックしたい関数を入れる
vi.mocked(userAge).mockReturnValue(2);

const result = doubleUserAge();
expect(result).toBe(4);
});
});
import { useAuthStore } from "@/store/auth-state";

// vi.mock() にモジュールのパスを入れる
vi.mock("@/store/auth-state");

test("", () => {
mockSession();
// ...
});

function mockSession(success = true) {
const returnValue = success
? {
credentials: {
accessKeyId: "......",
secretAccessKey: "......",
sessionToken: "......",
expiration: new Date(),
},
}
: null;

// vi.mocked() にモックしたい関数を入れる
vi.mocked(useAuthStore).mockImplementation(() => returnValue);
}
// vi.mock() にライブラリー名を入れる
vi.mock("axios");

test("第三方库/模块: Axios", async () => {
// vi.mocked() にモックしたい関数を入れる
vi.mocked(axios).mockResolveValue({ name: "userName", age: 2 });

const result = await doubleUserAge();
expect(result).toBe(4);
});
import { CognitoIdentityProvider } from "@aws-sdk/client-cognito-identity-provider";

// vi.mock() にライブラリー名を入れる
vi.mock("@aws-sdk/client-cognito-identity-provider");

test("", () => {
mockCognitoIdentityProvider();
});

function mockCognitoIdentityProvider(success = true) {
let mockAdminSetUserPassword;
let mockAdminRemoveUserFromGroup;
let mockAdminAddUserFromGroup;
if (success) {
mockAdminSetUserPassword = vi.fn().mockResolvedValue({});
mockAdminRemoveUserFromGroup = vi.fn().mockResolvedValue({});
mockAdminAddUserFromGroup = vi.fn().mockResolvedValue({});
} else {
mockAdminSetUserPassword = vi.fn().mockRejectedValue(new Error());
mockAdminRemoveUserFromGroup = vi.fn().mockRejectedValue(new Error());
mockAdminAddUserFromGroup = vi.fn().mockRejectedValue(new Error());
}

const mockReturn = {
adminSetUserPassword: mockAdminSetUserPassword,
adminAddUserToGroup: mockAdminRemoveUserFromGroup,
adminRemoveUserFromGroup: mockAdminRemoveUserFromGroup,
} as Partial<CognitoIdentityProvider>;

// vi.mocked() にモックしたい関数を入れる
// デフォルトでは、これは TypeScript に対して最初のレベルの値のみがモックされていると認識させます。
// でも、{ deep: true } を TypeScript に第二引数として渡すことができ、それによってオブジェクト全体がモックである(実際にそうである場合)と伝えることができます。
vi.mocked(CognitoIdentityProvider, true).mockImplementation(
() => mockReturn as CognitoIdentityProvider
);
}

vi.mock() で処理する場合のコード例:

vi.mock() を直接使用すると、モックはグローバルに有効になり、自動的に最上部に昇格します。

import { vi, it, expect } from vitest

// 自動的に最上部に昇格します。
console.log(userAge()) // 2

vi.mock('./user', () => {
return {
userAge: () => 2, // 実際の userAge 関数の実装を userAge: () => 2 で置き換えました。
}
})

it('* 2', () => {
const result = doubleUserAge()
expect(result).toBe(4)
})

it('other', () => {
// グローバルに有効になります。
console.log(userAge()); // 2
})

環境変数を処理する​

vi.stubEnv(env, val) を使用して環境変数を変更し、その後 vi.unstubAllEnvs() を使用して環境変数を元に戻します。

it("vi.stubEnv", () => {
vi.stubEnv("USER_AGE", 2);

const result = doubleUserAge();

expect(result).toBe(4);
});

afterEach(() => {
vi.unstubAllEnvs();
});

グローバル変数を処理する​

vi.stubGlobal(name, val) を使用してそのグローバル変数をモックすることができます。

たとえば、現在第三者のライブラリがグローバルに someone オブジェクトをマウントしており、そのオブジェクトには age 属性があります。

この場合、vi.stubGlobal(name, val) を使用してそのグローバル変数をモックすることができます。

it("double user age", () => {
vi.stubGlobal("someone", {
age: 2,
});

const result = doubleUserAge();

expect(result).toBe(4);
});

window.innerHeight のようなグローバル変数のモックも同様です。

it("double innerHeight", () => {
vi.stubGlobal("innerHeight", 100);

const result = doubleInnerHeight();

expect(result).toBe(200);
});

直接入力以外のモックすべきもの​

alert と console を処理する​

beforeAll(() => {
global.alert = vi.fn();
});

test("", () => {
// ...
expect(alert).toHaveBeenCalledWith("message");
});
const mockConsoleError = vi
.spyOn(console, "error")
.mockImplementation(() => undefined);

test("", () => {
// ...
expect(mockConsoleError).toHaveBeenCalled();
});

Math.random() を処理する​

vi.spyOn(Math, "random").mockImplementation(() => 0.2);

日付を処理する​

日付は予測不可能です。

テスト対象システム (SUT) に含まれる日付を安定かつ予測可能にするために、

この時、vi.setSystemTime(date) API を使用して日付をスタブすることができます。

コード例:

// テスト対象システム (SUT)
export function checkSunday(): string {
const today = new Date();

if (today.getDay() === 0) {
return "happy";
} else {
return "sad";
}
}
// テストコード
beforeEach(() => {
vi.useFakeTimers();
});
afterEach(() => {
vi.useRealTimers();
});

test("should be happy when it's Sunday", () => {
vi.setSystemTime(new Date(2024, 1, 14));

const result = checkSunday();

expect(result).toBe("happy");
});

· 3 min read

パラメータ化検証​

パラメータ化検証とは、複数のテストケースで同じテストロジックを再利用する方法を指します。

パラメータ化検証が解決する問題​

たとえば、以下の emailValidator 関数をテストする場合:

export function emailValidator(email: string): boolean {
const regex = /^[\w-]+(\.[\w-]+)*@([\w-]+\.)+[a-zA-Z]{2,7}$/;
return regex.test(email);
}

このようなテストコードを書くことが考えられます:

describe("emailValidator", () => {
it("should return true for a valid email", () => {
const email = "valid-email@example.com";
expect(emailValidator(email)).toBe(true);
});

it("should return false for a invalid email without domain extension", () => {
const email = "valid-email@example";
expect(emailValidator(email)).toBe(false);
});

it("should return false for a invalid email with extra dot at the end", () => {
const email = "valid-email@example.";
expect(emailValidator(email)).toBe(false);
});

it("should return false for a invalid email with missing '@'", () => {
const email = "valid-email.example.com";
expect(emailValidator(email)).toBe(false);
});

// ... ...
});

上記のすべてのテストケースは同じロジックを使用しており、入力と出力だけが異なります。

パラメータ化検証 (Object) を使う​

Vitest が提供する it.each API を使用して処理することができます。

これにより、複数の入力値と出力値に対して同じテストロジックを繰り返し実行することが容易になります。

テストケースの失敗を迅速に特定するためには、説明情報にプレースホルダーを使用することが重要です。

これにより、どのテストケースが失敗したかを容易に識別できます。

describe("emailValidator", () => {
it.each([
{ email: "valid-email@example.com", expected: true },
{ email: "valid-email@example", expected: false },
{ email: "valid-email@example.", expected: false },
{ email: "valid-email.example.com", expected: false },
])(
"should return $email when validating $expected",
({ email, excepted }) => {
expect(emailValidator(email).toBe(excepted));
}
);
});

オブジェクトを使用して入力と出力を構築する場合、プレースホルダーとして $parameterName の形式を使用することができます。

オブジェクトを使用する方法は可読性が高くなります。

重重複する検証をカプセル化する​

重複する検証文をなるべく関数にカプセル化して、理解しやすい名前をその関数に付けることが望ましいです。

コード例:

function assertCognito(
cognito: CognitoIdentityProvider,
isListUsersCalled = true
) {
const callArgs = {
UserPoolId,
};

if (isListUsersCalled) {
expect(cognito.listUsers).toHaveBeenCalledWith(callArgs);
} else {
expect(cognito.listUsers).not.toHaveBeenCalledWith(callArgs);
}

expect(cognito.listUsersInGroup).not.toHaveBeenCalledWith({
UserPoolId,
GroupName: "admin",
});
expect(cognito.listUsersInGroup).not.toHaveBeenCalledWith({
UserPoolId,
GroupName: "flt",
});
}

· 15 min read

バックドア操作によるテストデータの準備​

バックドア操作とは​

バックドア操作とは、非公開の API を呼び出してテストデータを準備することを指します。

例えば、Todo プロジェクトで removeTodo 機能(id で todo を削除)が正常に動作するかをテストしたいとします。

しかし、まだ addTodo 関数を実装していない場合があります。

この時、todos に直接 todo を push してテストを行うことができます。

const todo = {
id: 0,
title: "work",
};

store.todos.push(todo);

これがバックドア操作によるテストデータの準備です。

この操作方法はビジネスコードの実装と非常に密接に結びついています。

例えば、上記のコードは todo のデータ構造を露呈しています。

後に todo に属性が追加されると、このテストコードもエラーを引き起こす可能性があります。

脆弱なテスト​

このようなテストは脆弱なテストです。

このようなテストが増えると、みんながビジネスコードを変更することを恐れるようになります。

しかし、ここではまだ addTodo が実装されていないので、まずは一時的にバックドア操作を使用して removeTodo をテストすることもできます。

その後、addTodo 機能が実装されたら、バックドア操作を置き換える必要があります。

可能な限りバックドア操作を使用せず、round-trip 方法を優先してください。

round-trip とは、ソフトウェアテストにおいて、特定の機能やプロセスが開始点から終了点まで、そして元の開始点に戻るまでの全プロセスを通してテストするアプローチを指します。

プログラムの間接入力​

直接入力とは​

これは、ビジネスコード内の関数が引数を通じて直接データを受け取り、計算を行うことを指します。

関数を呼び出し、引数を渡すだけで、これが直接入力の方法です。

function add(a: number, b: number): number {
return a + b;
}

間接入力とは​

以下のコードのように、他のモジュール/関数/グローバルオブジェクトなどを通じて、引数以外の方法でデータを入力することを間接入力と呼びます。

export function doubleUserAge(): number {
// userAge を通じてデータを取得
return userAge() * 2;
}

間接入力が特別な処理を必要とする理由:

function userAge() {
return 23;
}

userAge は API のリクエストや store のデータ読み取りを通じて取得される可能性があります。

つまり、age は変更される可能性が高い値です。

const doubleAge = doubleUserAge();

expect(doubleAge).toBe(48);

直接入力のように固定してしまうと、age が更新されるたびにテストをメンテナンスする必要があります。

このようなテストは脆弱なテストです。

よく考えてみると、実際にテストしたいのは * 2 というロジックです。

age の値がいくつであるかは、実は重要ではありません。

userAge の値をコントロールする必要があります。

mock と stub​

stub とは何か​

stub とは、実際のロジック実装を置き換えるテスト用語です。

stub を使用することで、テストは外部の実際のコード実装から分離され、テストロジックがよりシンプルで理解しやすくなります。

mock と stub の違い​

単体テストにおいて:

  1. stub は間接入力を制御する方法であり、間接入力の実際の実装を置き換えます。

    stub は単に値を返すだけです。

    // stub
    vi.mock("packageName", () => {
    return {
    functionName: () => 2,
    };
    });
  2. mock はテストの代用品を指します。

    mock はテストの代用品として、行動検証に必要な相互作用情報を記録するだけでなく、検証も提供します。

    mock は stub に比べて、相互作用情報の記録と検証機能が追加されています。

    mock は stub の基礎に加えて、相互作用情報を記録します。

    // mock
    vi.mock("packageName", () => {
    return {
    functionName: vi.fn(() => 2),
    };
    });

最小準備データ原則​

データを準備する際には、その単体テストケースで必要とされるデータのみを提供します。

データが少ないほど、テストケースは読みやすくなります。 この原則に違反すると、コードの保守性と可読性が低下し、心理的な負担が増えます。

単体テストはビジネスコードのユーザーの一つです。

したがって、単体テストはビジネスコードをより良く書くためのドライバーになり得ます。

単体テスト自体は、簡潔さと可読性を重視しています。

単体テストもコードの一部であり、保守が必要です。

もしテストコードの保守にビジネスコードの保守よりも多くの時間がかかるなら、あなたはまだテストを書きますか?

他のされモジュールからエクスポートた関数に依存する​

vi.mocked().mockReturnValue()

vi.mock() は path のみを受け取り、その後に mock を行います。

import { userAge } from "./user";

vi.mock("./user");

describe("間接入力の値を制御する", () => {
it("* 2", () => {
vi.mocked(userAge).mockReturnValue(2);

const r = doubleUserAge();
expect(r).toBe(4);
});
});

この方法では、異なるテストケースで異なる値を mock することができます。

第三者ライブラリへの依存​

例えば Axios のような第三者モジュールを呼び出す場合、どのようにテストすればいいのでしょうか?

第三者ライブラリ/モジュールの関数を mock することは、自分たちが書いた関数を mock するのと同じです。

唯一の違いは、パスをモジュール名に変更することです。

vi.mock("axios");

it("第三者ライブラリ/モジュール: Axios", async () => {
vi.mocked(axios).mockResolveValue({ name: "nansen", age: 2 });

const r = await doubleUserAge();
expect(r).toBe(4);
});

定数による間接入力​

例えば、以下のコードでは、tellName 関数が定数 name を使用しています。

// config.ts

export const config = {
allowTellAge: true,
age: 18,
getAge() {
return 18;
},
};

export const name = "nansen";
export const gold = 3;
// tellName.ts

import { name } from "./config";

export function tellName() {
return name;
}

config.ts からエクスポートされた内容を直接 mock することができます。

// tellName.spec.ts

import { tellName } from "./tellName";

vi.mock("./config", () => {
return {
name: "n",
};
});

describe("定数による間接入力", () => {
it("should tell the name", () => {
const name = tellName();
expect(name).toBe("n");
});
});

注意点として、上記の方法で mock すると、config.ts の全てのエクスポート内容が変更されます。

つまり、元々 gold や config もエクスポートされていましたが、mock した後は存在しなくなり、name のみが残ります。

この場合、パラメータ importOriginal と API vi.importActual を使用して、他のエクスポートされた内容を取得できます。

  1. importOriginal

    // tellName.spec.ts

    import { tellName } from "./tellName";

    vi.mock("./config", async (importOriginal) => {
    const config = await importOriginal();

    return {
    ...config,
    name: "n",
    };
    });

    describe("定数による間接入力", () => {
    it("should tell the name", () => {
    const name = tellName();
    expect(name).toBe("n");
    });
    });
  2. vi.importActual

    // tellName.spec.ts

    import { tellName } from "./tellName";

    vi.mock("./config", async () => {
    const config = await vi.importActual("./config");

    return {
    ...config,
    name: "n",
    };
    });

    describe("定数による間接入力", () => {
    it("should tell the name", () => {
    const name = tellName();
    expect(name).toBe("n");
    });
    });

パラメータ importOriginal を使用することを推奨します。

なぜなら、パスを再度記述する必要がなく、コードがよりクリーンになるからです。

環境変数による間接入力​

以下の二つの方法で環境変数を取得できます。

// Node.js 環境下

process.env;
// Vite, Webpack などのバンドラー環境下

import.meta.env;

環境変数を使用した機能については、環境変数の値を直接変更してテストを行うことができます。

it("process.env", () => {
process.env.USER_AGE = 2;

const r = doubleUserAge();

expect(r).toBe(4);
});

しかし、環境変数を元の値に戻したい場合は、vi.stubEnv(env, val) を使用して環境変数を変更し、vi.unstubAllEnvs() で環境変数を復元できます。

it("vi.stubEnv", () => {
vi.stubEnv("USER_AGE", 2);

const r = doubleUserAge();

expect(r).toBe(4);
});

afterEach(() => {
vi.unstubAllEnvs();
});

vi.unstubAllEnvs() は通常 afterEach と一緒に使用されます。

グローバル変数による間接入力​

グローバル変数による間接入力には通常、二つのシナリオがあります。

window.innerHeight などのグローバル変数の使用;

第三者ライブラリなどが提供するグローバル変数の使用。

たとえば、現在第三者ライブラリがグローバルに user オブジェクトを提供しており、そのオブジェクトには age プロパティがあります。

この場合、vi.stubGlobal(name, val) を使用してそのグローバル変数を mock することができます。

it("double user age", () => {
vi.stubGlobal("user", {
age: 2,
});

const r = doubleUserAge();

expect(r).toBe(4);
});

window.innerHeight のようなグローバル変数の mock も同様の方法で行います。

it("double innerHeight", () => {
vi.stubGlobal("innerHeight", 100);

const r = doubleInnerHeight();

expect(r).toBe(200);
});

vi.unstubAllGlobals でグローバル変数を復元できます。

間接層処理のテクニック​

❗ 一層の間接層で解決できない問題はない。もし存在するなら、もう一層追加すればいい。

このテクニックは非常に強力で、すべての間接入力を処理する方法を、関数やオブジェクトの形で扱うことに変換できます。

また、複雑なテストやビジネスコードを単純化するためにもこのテクニックを使用できます。

例えば、以下のようなコードがあります:

// doubleHeight.ts

export function doubleHeight() {
return innerHeight * 2;
}
// doubleHeight.spec.ts

it("double innerHeight", () => {
vi.stubGlobal("innerHeight", 100);

const r = doubleHeight();

expect(r).toBe(200);
});

直接グローバル変数を操作したくない場合、間に一層の中間層を加えて処理することができます:

// doubleHeight.ts

import { innerHeightFn } from "./window";

export function doubleHeight() {
return innerHeightFn() * 2;
}
// window.ts

export function innerHeightFn() {
return innerHeight;
}
// doubleHeight.spec.ts

vi.mock("./window.ts", () => {
return {
innerHeightFn: () => 100,
};
});

it("double innerHeight", () => {
const r = doubleHeight();

expect(r).toBe(200);
});

API のテスト方法​

以下のサンプルコードを用いて、API をテストするための方法を紹介します。

export function fetchAddTodo(title: string) {
return axios.post("/api/addTodo", { title }).then(({ data }) => {
return data;
});
}

上のコードには 4 つの層があります:

graph LR

A[ビジネスコード] --> B[中間層 fetchAddTodo インターフェース] --> C[Axios] --> D[サーバー]

最も外側の層はビジネスコードです、

中間層は fetchAddTodo インターフェースです、

fetchAddTodo インターフェースは Axios を使用して API にリクエストを送ります、

最も内側の層は、最終的にブラウザからサーバーに送られるリクエストです。

中間層を mock する​

vi.mock('./todo')

test("add todo", () => {
vi.mocked(fetchAddTodo).mockImplementation(title) => {
return Promise.resolve({
data: { data: { id: 1, title } },
state: 1,
});
};

setActivePinia(createPinia());

const todoStore = useTodoStore();
const title = "eat";

await todoStore.addTodo(title);

expect(todoStore.todo[0].title).toBe(title);
})

この方法は fetchAddTodo インターフェースを露出していますが、これらのインターフェースは非常に安定しています。

したがって、axios を mock するよりも中間層を mock する方が良く、最も推奨される API テストの方法です。

直接 axios を mock する実装方法の欠点は、実装の詳細(axios)が露出することです。

もしいつか axios が別の方法に置き換えられた場合、これらのテストもすべて置き換える必要があります。